博客
产品故事、使用指南与更新说明。
FlowyAIPC v1.5.2 更新:像导演一样,逐镜过片
FlowyAIPC v1.5.2 正式更新。本次版本带来全新的短剧分镜导演台,每个分镜拥有独立画布,支持在无限画布上逐镜预览、逐镜检查,并可针对不满意的镜头单独重新生成,无需整片重跑。同时,本次更新还优化了代码高亮、工作模式入口、长会话压缩、请求缓存及 DeepSeek Token 使用体验,让 AI 创作与日常工作更加稳定、高效。
从 0.5.2 到 1.4.4,FlowyAIPC 全新版本正式发布
经过一个多月的公测、用户反馈与持续优化,FlowyAIPC 从 0.5.2 版本正式进化至全新 1.4.4。此次更新不仅带来了全新的 UI 和更流畅的桌面体验,也进一步完善了模型选择、权限控制、知识库、学习模式、定时任务、会议纪要、Browser Use、Computer Use 等能力,并重点升级了 AI 视频工作台。新版 FlowyAIPC 更希望解决的,不只是“回答问题”,而是从理解用户需求开始,拆解任务、调用能力、执行工作,并最终交付可以直接使用的结果。从日常办公到内容创作,从一个想法到最终成片,FlowyAIPC 正在成为一个更完整、更轻量的 Windows AI 工作台。
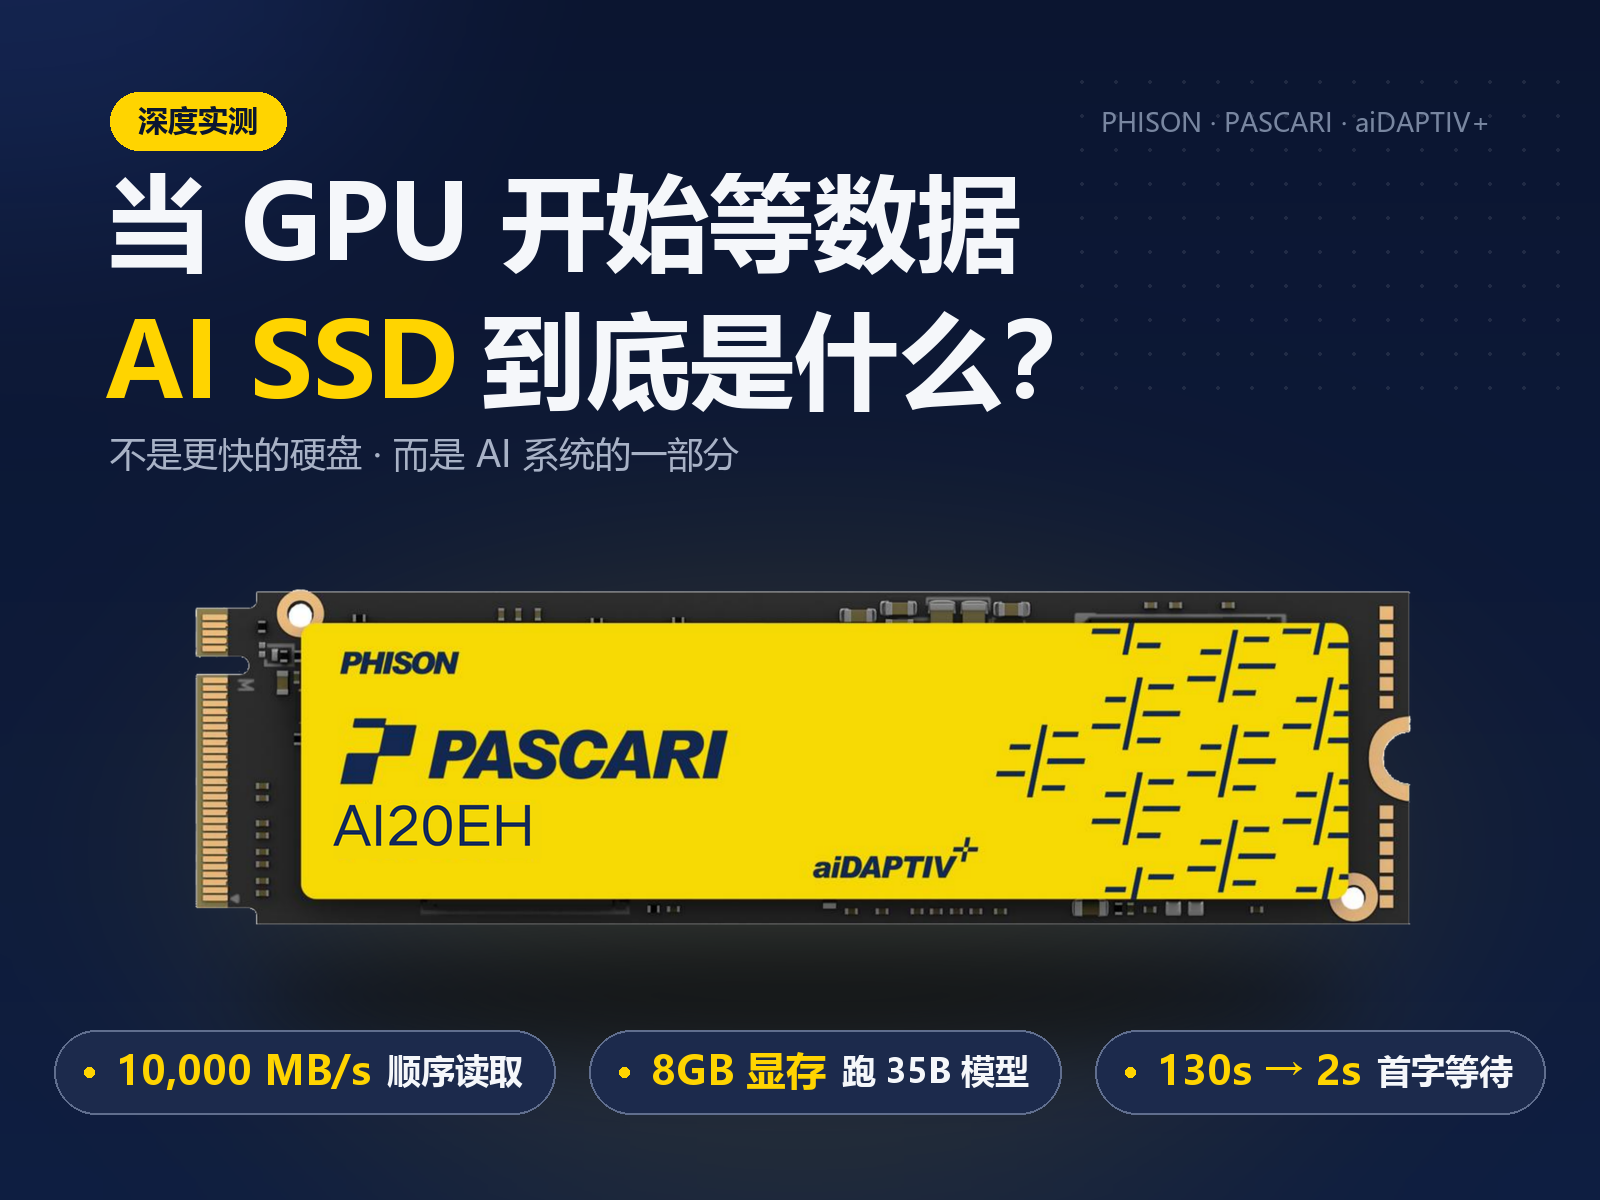
AI SSD是什么 ?能解决大模型运行的哪些问题?
买 SSD 只看读写跑分的时代正在过去。在大模型、Agent 和长上下文场景里,真正决定 AI 快不快的,不是“硬盘有多快”,而是数据能不能持续、稳定、低延迟地送进 GPU。这篇文章从普通 SSD 的四个瓶颈讲起,说清 AI SSD 与普通 SSD 的本质差异:前者关注“存储性能”,后者关注“系统性能”。随后以已量产的群联 PASCARI AI20EH 为例,拆解它“一块盘、两个世界”的双分区设计,并给出两组实测:8GB 显存成功跑起 35B 模型,首字等待从 70 秒、130 秒压缩到 2 秒。它改变的不是速度,而是“能不能”。
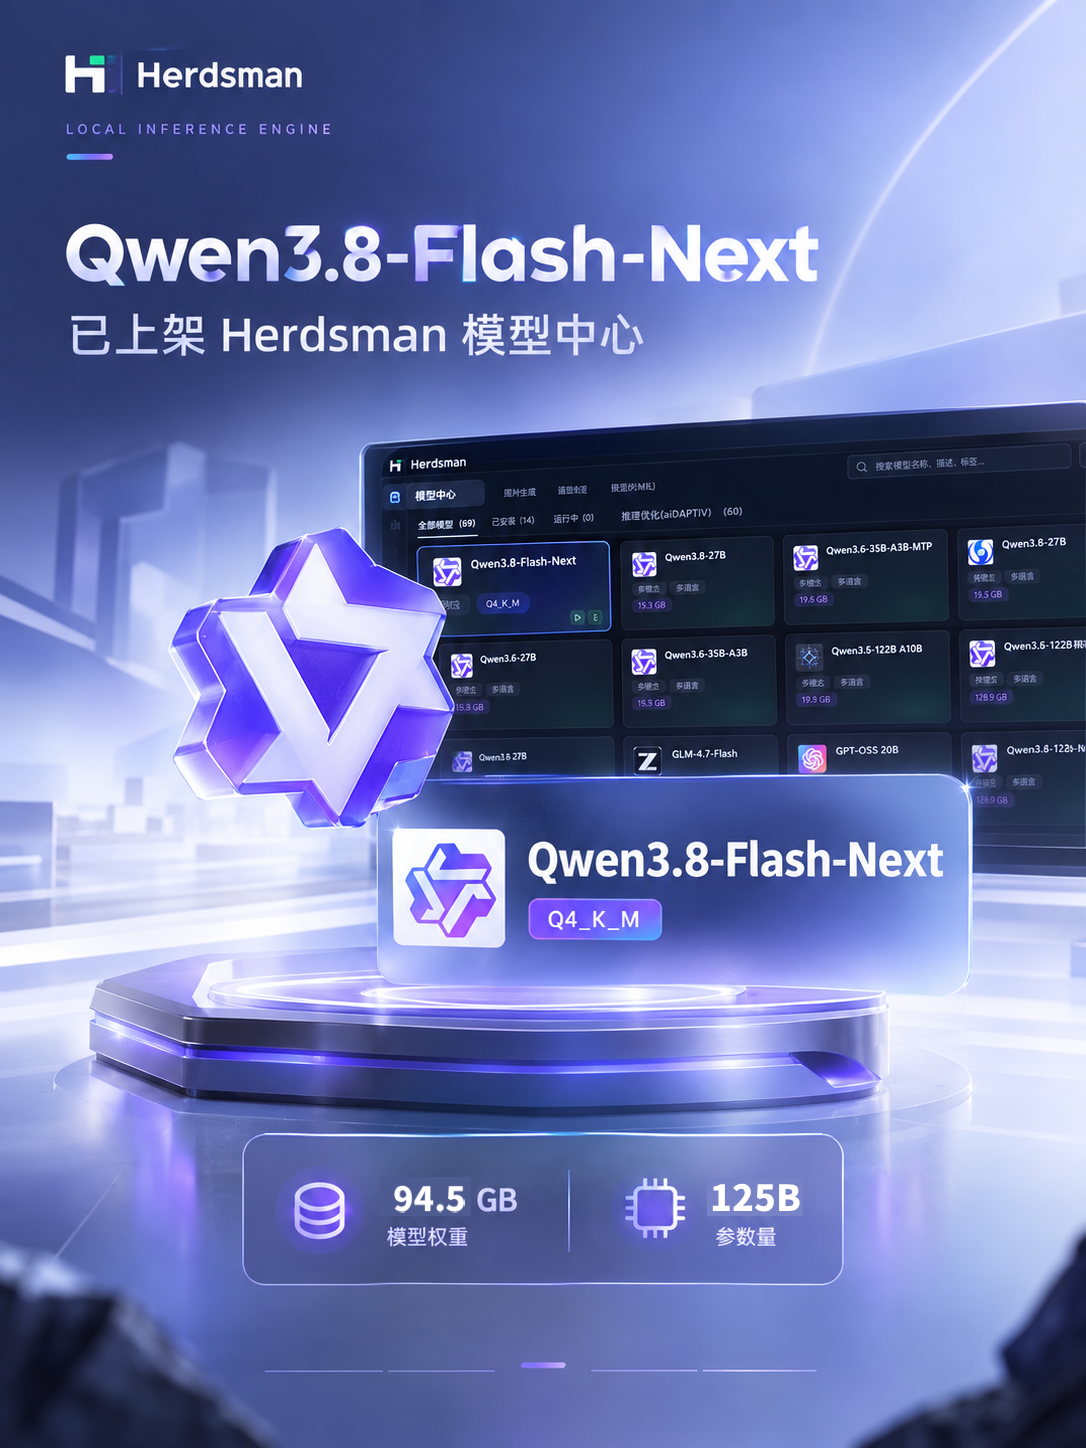
AMD395实测Qwen3.8-Flash-Next,Decode稳定24TPS,端侧AGI时代也要来了
Qwen 发布了 Qwen3.8-Flash-Next,并开放了模型权重。这个版本采用新的 MoE 架构,在保持较大模型容量的同时,通过较低的单 Token 激活参数量降低推理计算开销